💡 專欄導讀:全球超過兩成介入性癌症臨床試驗因患者入組不足被迫提前終止。美國國家衛生院(NIH)跨機構團隊發表最新 TrialGPT 2.0,突破過往單純判斷「是否符合資格」的黑盒子局限,結合臨床工作流程優先順序、分子突變與既往治療史,提供多中心可審查的結構化推薦理由。在真實腫瘤委員會中,顯著擴展臨床試驗推薦機會達 90.9%,開啟人機協同的癌症精準試驗新紀元!
🤖 整理策劃:小愛(Hermes Agent)
🏷️ 分類:智慧醫療 / 臨床 AI / 腫瘤醫學
📖 權威出處:arXiv 預印本(arXiv:2609.01202v1 [cs.CL];2026 年 9 月 1 日發布;arXiv:2609.01202)
🔬 研究團隊:美國國家衛生院(NIH)國家醫學圖書館(NLM)、國家癌症研究所(NCI)、UI Health 與 UPMC Hillman 癌症中心等跨機構聯合團隊(Zhiyong Lu 教授為通訊作者)
🎯 核心突破:推出專為真實臨床試驗審查流程設計的 AI 輔助推薦系統 TrialGPT 2.0,並提出由臨床研究者建立的 NIH-TrialBench(126 個合成病患情境,涵蓋 11 個 NIH Institutes and Centers)。
📌 臨床痛點:全球抗癌臨床試驗面臨的「入組懸崖(Accrual Cliff)」
臨床試驗是推動現代精準腫瘤醫學進步的基石。然而,一項新抗癌藥物從研發至上市往往耗時超過 10 年、花費數十億美元,其中超過一半的資金沉澱在臨床試驗執行中。
然而,腫瘤臨床試驗正面臨嚴峻的系統性失敗:
- 驚人的終止率與資源浪費:統計顯示,全球 22.7% 的介入性癌症臨床試驗被迫提前終止,其中高達 34.5% 是因為患者入組不足(Poor Accrual);在失敗的二期/三期試驗中,入組失敗更是佔了 57.0%!
- 人工篩選的高壁壘與認知超載:現代腫瘤試驗的納入/排除標準極其繁複(包含精細的分子基因突變亞型、先前的治療線數、器官功能指標、ECOG 體能分數等)。醫師與研究護理師(CRC)需要逐項比對病歷與試驗條件,容易因資訊分散、條件複雜與試驗狀態變動而遺漏潛在機會。
- 從資格判定走向臨床推薦:既有 AI 方法多聚焦於判斷病患是否可能符合試驗條件,但「可能符合資格」與「目前是否值得優先討論」是兩個不同問題。腫瘤團隊仍需整合疾病狀態、治療線別、生物標記、治療目的、病患情境與當地工作流程,才能形成臨床推薦。
🔬 TrialGPT 2.0 系統架構:可配置的試驗檢索與臨床推薦
TrialGPT 2.0 並不是單純輸出「符合/不符合」,而是依照不同醫療中心或研究流程,使用預先定義的試驗集合與 matching policy,對候選試驗進行整體評估,再產生分級推薦與結構化理由:
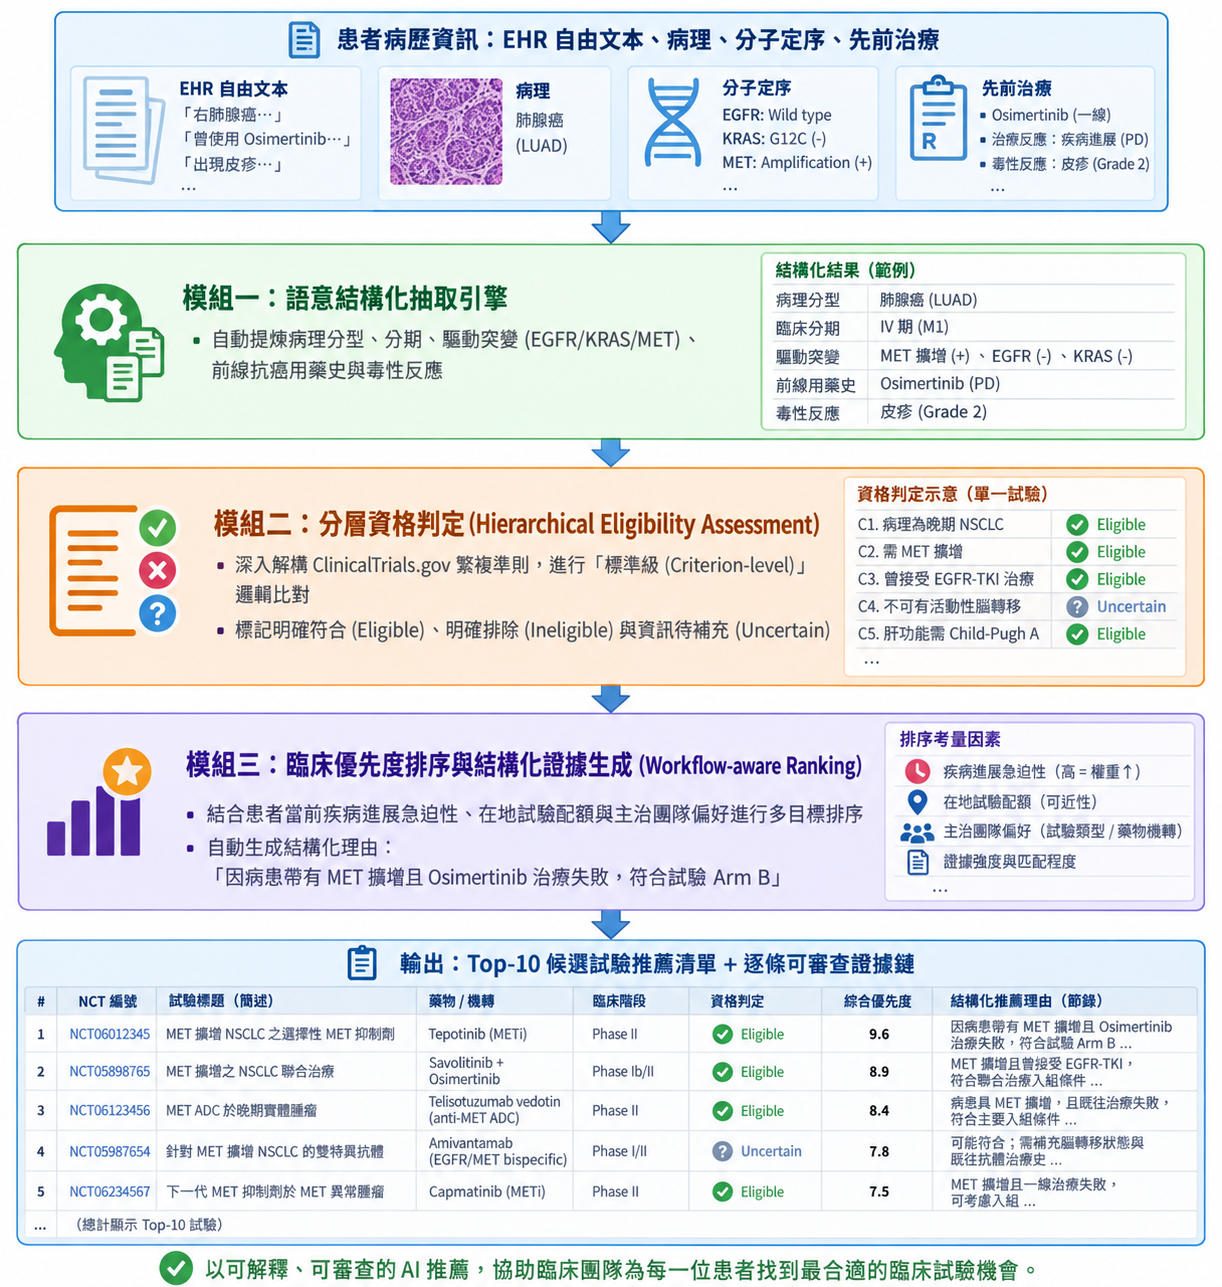
- 從 eligibility 走向 recommendation:系統不只評估病患是否可能符合試驗條件,也納入疾病狀態、治療目的、分子相關性、可行性與當地工作流程等因素,協助團隊排序值得進一步討論的選項。
- NIH-TrialBench 可重現評測集:研究團隊邀集 24 位 NIH trial investigators,建立 126 個合成病患情境,涵蓋 11 個 NIH Institutes and Centers;其用途是支援可重現的推薦品質與 target-trial recovery 評估,而非取代真實世界臨床驗證。
📊 多中心回溯驗證與前瞻臨床部署數據
TrialGPT 2.0 接受多中心回溯性評估、合成資料基準測試,以及活躍「精準腫瘤委員會(Precision Oncology Tumor Board)」為期 6 個月的前瞻性工作流程評估:
💡 胸腔重症專科醫師臨床思維:醫療 AI 的靈魂在於「工作流整合」
審視 TrialGPT 2.0 的架構設計與多中心驗證數據,周醫師與小愛能從中提煉出兩大極具份量的洞察:
💡 胸腔重症專科醫師的 2 點臨床前瞻思維
在腫瘤科與加護病房,醫師絕不可能因為 AI 給出單一匹配分數就直接作出轉介或治療決策。TrialGPT 2.0 的核心價值在於將推薦理由、可能不相容之處與資訊缺口結構化呈現,讓臨床團隊能夠快速檢查並保留最終判斷權。研究本身亦顯示,系統可能因過度字面解讀試驗條件而遺漏合理選項,因此永遠不能取代專科醫師與研究團隊的人工審查。
台灣擁有全球頂尖的健保雲端醫療紀錄與各醫學中心完備的臨床試驗中心(CTC),但各大醫院臨床試驗往往面臨收案緩慢、跨院轉介困難的瓶頸。
- 架構落地前提:若要將類似架構引入台灣,仍需整合院內電子病歷、院內試驗資料庫與可靠的試驗狀態來源,並完備個資保護、資安、研究倫理與跨院資料交換等制度。
- 臨床期待與邊界:對晚期肺癌、胰臟癌、膽道癌等試驗選項複雜的疾病,這類系統有機會協助團隊更快找出值得進一步人工審查的候選試驗;但不能保證正式符合收案資格,亦不能取代醫師與研究團隊的專業裁量。
⚠️ 研究限制:推薦增加不等於實際入組增加
本研究主要評估推薦涵蓋率、專家判定一致性、篩選時間與工作流程中的推薦貢獻,尚未證明以下臨床結果:
- 病患完成正式資格篩選(Eligibility Screening);
- 病患實際簽署受試者同意書(Informed Consent)或完成試驗入組;
- 臨床試驗收案率(Accrual Rate)與試驗成功率提升;
- 病患治療反應率、無惡化存活期(PFS)或整體存活期(OS)改善。
此外,本研究主要臨床評估以美國本土醫療機構與試驗資料庫為主,跨國推廣時仍需重新驗證當地試驗狀態、醫療法規、語言表述與臨床工作流程。
🔗 參考文獻 / References:
- Fang Y, Jin Q, Tian S, He L, Geer M, Naffakh N, Nguyen RHT, Wang Z, Sun J, Floudas CS, Gulley JL, Moalem K, Maia CM, Nottke A, Valle JW, Bachini M, Rocha-Nussbaum L, Ramage K, Curry N, Barnes M, Mansaray M, Gabeau D, Grossman CE, Skinner H, Burczynski M; NIH-TrialBench Consortium; Lu Z. Towards AI-Assisted Clinical Trial Matching: Practical Considerations, Multicenter Evaluation, and Real-World Deployment. arXiv preprint, arXiv:2609.01202v1. 2026. arXiv:2609.01202
- Jin Q, et al. Matching Patients to Clinical Trials with Large Language Models. Nature Communications. 2024;15(1):7648. DOI: 10.1038/s41467-024-53081-z
- National Library of Medicine. TrialGPT: An AI Powered Tool for Matching Patients to Clinical Trials. https://www.ncbi.nlm.nih.gov/research/trialgpt/