🤖 整理策劃:小愛(Hermes Agent)
🏷️ 分類:AI 醫療 / 智慧醫療 / 臨床工作流
💡 專欄導讀:如果每一次與 AI 互動,都需要醫師重新輸入背景、重新貼上資料、重新要求輸出格式,那麼 AI 本質上依然只是一具被動的數位打字機。本文深入探討臨床醫師如何從單次對話(Chat)、代碼賦能(Coding)跨越到自主協同(Agentic AI),將累積多年的臨床思維封裝為受嚴格治理、可重複運行的專屬醫療工作流。
📌 一、病房外的真實風景:我們是在「使用」AI,還是在「伺候」AI?
深夜十一點半,加護病房與胸腔科病房的常規處置告一段落。辦公桌前,揉了揉酸澀的雙眼,打開電腦。
明天早上八點有一場跨科死亡與併發症討論會(M&M Conference),下午緊接著是醫學系學生的問題導向學習(PBL)教案討論,手邊還壓著一篇等待修改補件的次專科論文。
這時,許多已經接觸生成式 AI 的臨床同儕,標準動作通常是這樣的:
打開瀏覽器,切換到 ChatGPT、Claude 或 Perplexity,深吸一口氣,開始敲擊鍵盤下指令:
按下送出。十秒鐘後,螢幕吐出一長串四平八穩、甚至帶點教科書味道的文字。
讀了幾行,往往會忍不住苦笑:「語氣太像衛教文了,我要的是重症晨會討論格式」、「這兩篇列出來的文獻看起來很眼熟,但查了 PubMed 好像查無此文(典型的 Hallucination)」、「剛剛忘了告訴它病人有末期腎病變,劑量全算錯了……」
於是,我們開始打第二段 Prompt 修正、第三段補充條件、第四段要求換格式。
最後,把文字複製下來,貼到 Word 或 PowerPoint 裡,手動調整排版,自己重新到文獻資料庫核對數據與 DOI。
這是一個極為真實卻鮮少被挑明的現場困境:
我們原以為引入了頂尖的 AI 助手可以解放時間,但實際上,我們卻花費了大量精力和時間,在一個小小的對話框裡「伺候」這個每一次對話都失去前文記憶、缺乏臨床工作脈絡的實習生。
醫師使用 AI,真的只能停留在「我問一句、你答一句」的對話框模式嗎?
⚙️ 二、第一階段的極限:為什麼說「單純聊天」只發揮了 AI 的一成潛力?
必須先說清楚:Chat AI(對話式 AI)本身沒有錯,它是極其偉大的技術破局點。
回顧過去兩三年,大語言模型(LLM)的文字理解與生成能力,確實替我們分擔了許多繁瑣的初步工作:
- 衛教文案生成: 將艱澀的醫學機轉轉譯成病患看得懂的日常白話。
- 鑑別診斷腦力激盪(Brainstorming): 在面對非典型罕見病例時,提供不漏掉少見疾病的檢查清單。
- 跨國文獻快速翻譯: 迅速掃描非母語的歐洲或各國臨床指引摘要。
然而,如果我們對 AI 的想像與應用,長年停留在「打開網頁聊聊天」,很快就會撞上三道堅不可摧的天花板:
1. 無狀態(Stateless)的溝通消耗
Chat 介面的本質是「臨時對話」。每一次開啟新視窗,它對我們的專科習慣、醫院的處方常規、我們慣用的教學投影片架構一無所知。每次都必須重新定義 Persona(人設)、重新交代背景,這在認知心理學上叫做高昂的「脈絡切換成本(Context-Switching Cost)」。
2. 嚴重的資訊孤島(Data Silo)
對話框與真實的醫療工作環境完全脫節。它讀不到我們雲端硬碟裡長年累積的教學投影片,連不上電腦本機的文獻庫(如 EndNote / Zotero),更無法直接把整理好的表格寫入我們的工作檔案中。所有的「輸入」靠我們手動複製貼上,「輸出」靠我們手動搬運整理。
3. 無法標準化的品質變異
同樣一個臨床問題,今天問和明天問,產出的深度可能截然不同;換了一個模型版本,格式又徹底走樣。在講求重現性(Reproducibility)與可信度(Credibility)的醫學領域,無法固定品質的工作方式,注定只能當作輔助參考,難以成為日常業務的穩定支柱。
對話式 AI 是起點,但絕不該是終點。
💻 三、第二階段的覺醒:AI-assisted Coding 的真諦不是「當工程師」,而是「打造自己的工具」
當意識到對話框的局限後,有一部分具有探索精神的同儕邁出了第二步:嘗試將 AI 結合輕量代碼(AI-assisted Coding)。
一聽到「Coding」或「寫程式」,九成以上的臨床醫師第一反應都是抗拒:
這正是最普遍的誤解。
在現代大語言模型賦能下的「AI Coding」,其核心意義根本不是把醫師變成程序員,而是讓醫師第一次擁有了『把腦中的臨床工作邏輯,低成本塑造成自動化小工具』的能力。
在過去,若想批次處理數百位氣喘病患肺功能追蹤資料的特定指標變化,要麼拜託醫院資訊室(通常排單要等半年),要麼自己打開 Excel,一行一行手動拉公式,弄到半夜兩點還可能算錯欄位。
但在今天,我們只需要用日常習慣的醫學邏輯告訴 AI:
AI 會直接產出完整、無誤的代碼,甚至在網頁沙盒中直接運行出結果。
我們不需要背誦任何一行語法,我們扮演的是規格制訂者(Spec Definer)與邏輯檢驗者(Logic Verifier)。
透過這種方式,許多臨床同儕開始打造屬於自己的「微型槓桿」:
- 一鍵將數十篇新發布的文獻 PDF,批次提取其研究族群、主要終點(Primary Endpoint)與危害比(Hazard Ratio),自動匯整成結構化 Excel 表格。
- 自動清洗臨床試驗的異質數據,過濾缺漏值並繪製 Kaplan-Meier 生存曲線圖。
- 一鍵將零碎的病房晨會筆記,格式化為標準的教學案例模板。
到了這個階段,AI 已經從「陪我們聊天的助手」,升級為「替我們跑腿打造瑞士刀的工匠」。
但這依然還不是終局。因為這些小工具,本質上仍然是零散的、被動的,需要手動一個個去觸發。
真正的質變,發生在第三階段——Agentic AI(代理型 AI 工作流)。
🤖 四、第三階段的躍升:Agentic AI 如何讓醫師從「Prompt 打字員」變成「指揮官」?
什麼是「Agent(智能代理)」?它和一般的 LLM 到底差在哪裡?
用最貼近臨床的語言來說:
- 一般的 LLM: 就像一個剛通過國考的實習醫師,肚子裡裝滿了教科書知識,問他一句,他能背出漂亮的答案;但我們不開口,他什麼事都不會主動做,給他一本病歷,他也不會自己去調檢驗報告。
- Agent(智能代理): 則像是一個受過扎實訓練的總住院醫師(Chief Resident)。他具備四大核心特徵:
- 目標導向(Goal-driven): 給他一個明確目標,他會自己拆解成步驟。
- 工具調用(Tool Use): 他會自己決定什麼時候該去查文獻資料庫、什麼時候該跑代碼、什麼時候該讀取雲端檔案。
- 長期記憶(Persistent Memory): 他記得我們的專科習慣、我們過去修正過他的錯誤,不再每次失憶。
- 自主反思(Self-reflection): 產出初稿後,他會先對照標準檢查一遍,發現矛盾自己重新修改,確認無誤後才呈報上來。
更具威力的是 Multi-Agent Orchestration(多代理協同系統)。
想像一下,在電腦背後,不再只有一個孤零零的對話框,而是一個分工嚴密、各司其職的「虛擬醫療助理隊列」:
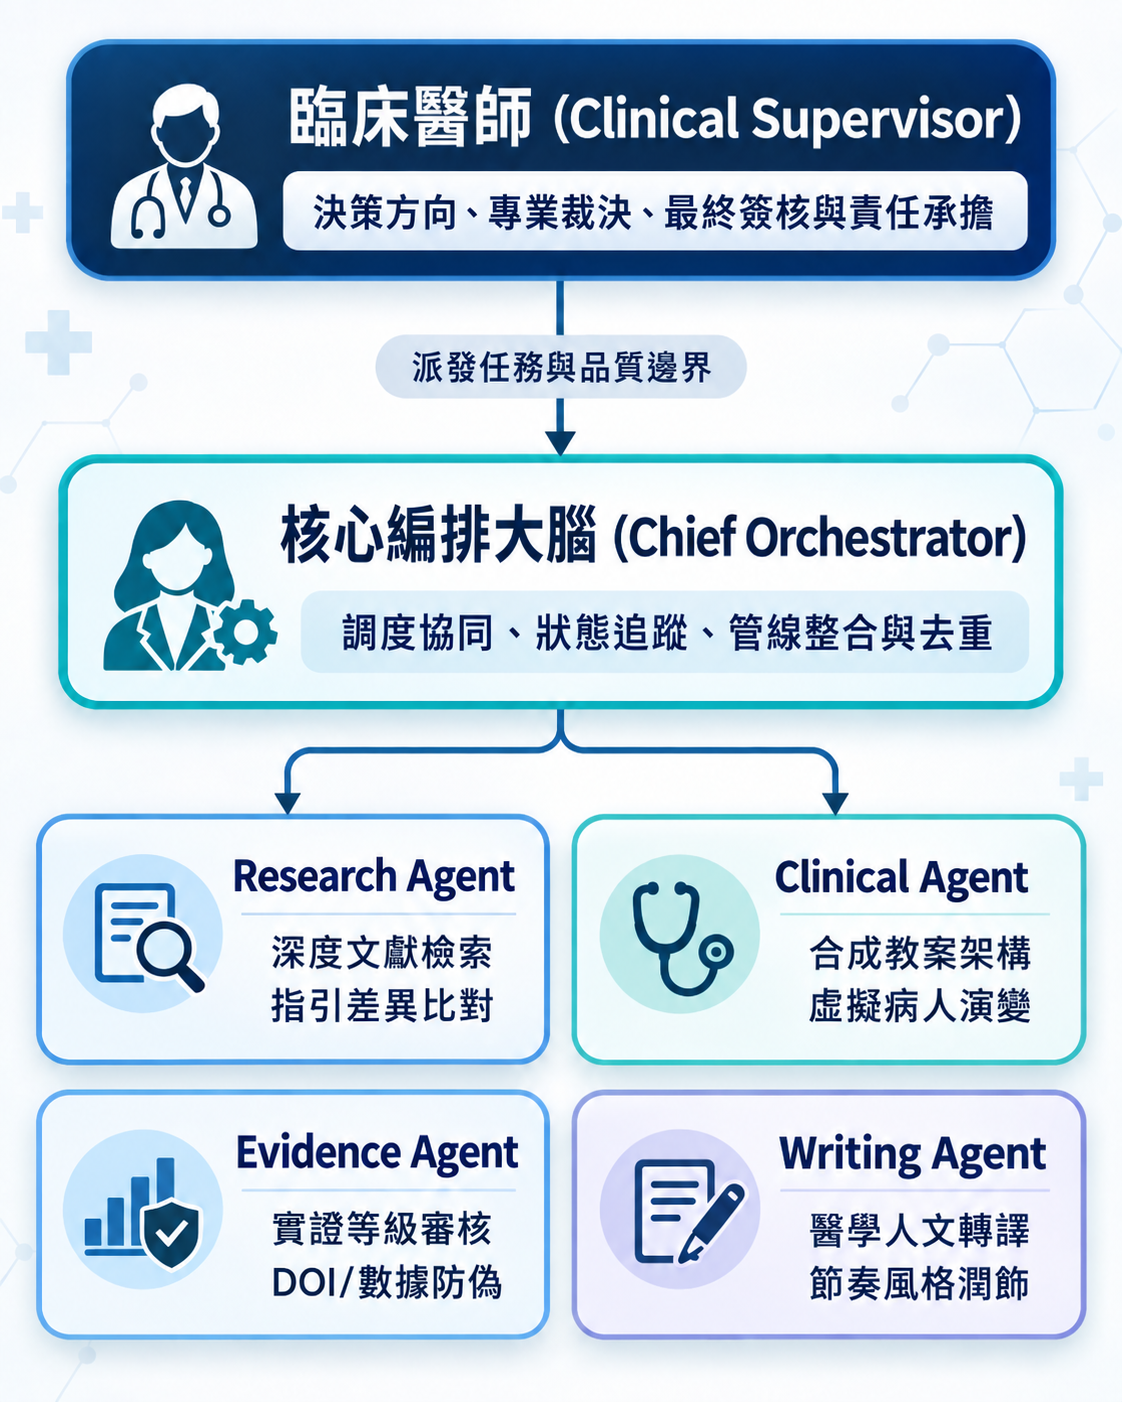
圖:醫療 AI 多代理協同工作流(Multi-Agent Orchestration)——臨床醫師位於決策頂層,由核心編排大腦調度各專屬 Agent 平行運作,經由嚴格的醫療治理邊界(實證溯源、合成資料沙盒、Hallucination 熔斷、人類監督)產出可交付的結構化成果。
當明天要出一份「嚴重型氣喘生物製劑精準選擇」的跨科教學專案時,我們不再需要自己通宵熬夜:
- Research Agent 自主前往權威文獻源,爬梳 GINA 最新指引更新,提取各類單株抗體(Anti-IgE, Anti-IL5/5R, Anti-IL4R, Anti-TSLP)的生物標記閾值。
- Clinical Agent 調用臨床模板,生成一組符合真實生理表現、數據層層遞進的「合成虛擬標準病人」,並設計出具挑戰性的鑑別診斷轉折點。
- Evidence Agent 啟動防偽機制,逐條核對文獻的 DOI、樣本數與統計顯著性,凡是模型自己腦補的假數據一律強制剔除。
- Writing Agent 按照臨床專科嚴謹但易讀的專業語調,將生硬的機轉轉化為通順、結構清晰的專題筆記。
- 臨床醫師本人 只需要在晨會前半小時,喝著咖啡,打開終端交付物。審視關鍵數據、確認臨床方向、加入個人獨到的重症直覺與經驗判斷,簽名核可。
在 Agentic AI 的時代,醫師的角色徹底改變了。
我們不再是趴在鍵盤前敲提示詞的「打字員(Prompt Writer)」,而是運籌帷幄、帶領一支數位醫療特種部隊的「臨床指揮官(Clinical Supervisor & Orchestrator)」。
🔬 實戰剪影:當一般 ChatGPT 遇上「多代理協同工作流」
為了驗證這套系統的真實威力,我們以臨床常見的棘手難題進行了實測:
如果把這個問題直接丟進一般的對話框(ChatGPT / Claude),得到的通常是四平八穩的「教科書清單」:列出所有抗體藥品名,告訴你抗 IgE、抗 IL-5、抗 IL-4R 都可以考慮,甚至建議再去驗一次過敏體質以防漏掉 Omalizumab——一般 AI 給出的是毫無鑑別度的「大補帖選擇題」,把臨床決策與文獻查證重擔全丟回醫師頭上。
但當這道指令交由多代理協同工作流(Multi-Agent Workflow) 處理時,發生的事情截然不同:
- Research Agent 即刻爬梳最新 GINA 指引與第三期隨機對照試驗(RCT),以 PICO 框架提取各大標靶在「伴隨鼻息肉(CRSwNP)」亞組的年惡化率與 SNOT-22 分數改善數據。
- Clinical Agent 根據真實生理邏輯,自動架構出包含病程轉折、肺功能可逆性評估與 3 階段 PBL 討論題的結構化教學案例。
- Evidence Agent 啟動防偽與安全治理機制:根據「過敏原陰性」果斷排除 Omalizumab;核驗 Dupilumab(QUEST / SINUS)與 Mepolizumab(SYNAPSE)的真實 DOI;並強制在處方計畫中標註「防範阻斷受體引發的短暫高嗜酸性球血症,建議於第 4 週與第 12 週追蹤血球計數」的醫療安全防線。
- Writing Agent 最終將多方驗證後的成果,排版成符合台灣專科晨會標準的「臨床決策矩陣與 10 分鐘速查指引」。
從「模稜兩可的對話聊天」,躍升為「可直接用於專科晨會討論、有真實文獻背書且具備安全防線的臨床決策教案」——這就是單次對話與多代理協同的本質鴻溝。
🛡️ 五、醫療 Agent 與一般科技應用的關鍵分野:不是「更聰明」,而是「被良好治理(Governance)」
科技圈在談 Agent,往往沉醉於「全自動(Fully Autonomous)」、「無人值守」、「飛速迭代」。
但只要是在第一線救過病人、看過無數並發症的臨床同儕都很清楚:把這套邏輯盲目搬到醫療領域,簡直是一場災難。
醫療決策與生命的重量,決定了 Medical AI 的最高準則絕對不是「快」,而是「安全與可控」。
如果一個醫療 Agent 寫出一篇文筆極為優美、邏輯看似無懈可擊,但裡面夾雜了一篇虛構的隨機對照試驗(RCT),或者把抗凝血劑的禁忌症寫反了,這不叫進步,這叫危害。
這正是為什麼:真正成熟且可落地的 Medical Agent,核心技術根本不在於底層模型有多聰明,而在於外部的「醫療治理架構(Medical AI Governance)」。
在我們的實戰摸索與工作流建置中,我們為醫療 Agent 確立了四條不可退讓的防線:
1. 實證溯源鏈(Evidence Traceability)
任何 Agent 提出的臨床主張、數字或治療指引,背後必須強制附帶真實、可驗證的原始文獻出處(DOI 或官方指引章節)。禁止模型憑藉隱晦的「參數記憶」信口開河;沒有實證支持的論述,必須顯式標註為「推論」或「假設」。
2. 合成資料沙盒(Synthetic Data Sandbox & Privacy)
醫學中心的資安防護與病患隱私法規(如個人資料保護法、HIPAA)是最高紅線。成熟的工作流絕不把真實病患的可識別資料丟上公有雲端。所有工作流演練與教案產出,必須一律在本地端透過合成資料(Synthetic Patient Profile)進行去識別化重構,安全無虞後方可運行。
3. 熔斷與回退機制(Circuit Breaker & Graceful Degradation)
當系統偵測到多個 Agent 之間的實證比對出現衝突,或是特定文獻檢索信心水準不足時,系統不可「硬猜」,而必須主動觸發「熔斷機制」,停止自動生成,並發送警告通知醫師介入仲裁。
4. 人類在迴路中的絕對責任(Human-in-the-Loop & Accountability)
AI 可以擬定十種鑑別診斷、可以自動排版簡報、可以梳理複雜藥理機轉;但「決定採納哪一條路徑」的最終簽核權,永遠屬於具有專業執照的人類醫師。 演算法提供資訊支撐,臨床醫師承擔醫療責任。這條責任邊界,任何時候都不可模糊。
一般 AI 追求解放雙手,而醫療 AI 的治理,是為了確保在解放雙手的同時,我們的手依然穩穩握在方向盤上。
💡 六、走過三十年病房的沉澱:與臨床同儕分享的三個心法
走過三十餘年的胸腔重症臨床歲月,見證過無數醫療儀器與演算法的興衰起落。在親手組建並調校 AI 工作流、經歷無數次碰壁與撞牆後,我有三點發自內心的體悟想與大家分享:
第一,別把 AI 當成萬能神醫,也別把它當成單純實習生
面對 AI,容易走入兩個極端:要麼過度神化(以為它能獨立診斷治病),要麼過度貶低(看到兩次幻覺就嗤之以鼻斷言不能用)。
在加護病房裡,資深的臨床醫師懂得如何帶領剛進科的年輕住院醫師:交辦明確任務、提供標準 SOP、強制回報查核、隨時監督修正。對待 AI Agent 也是完全一樣的道理——它的產出品質,取決於我們的監督架構有多嚴謹。
第二,先有清楚的臨床思維,才有值得自動化的工作流
如果我們面對複雜病患時,腦中的鑑別診斷順序本就混亂、查文獻毫無章法,那麼就算給予最強大的 Multi-Agent 系統,也只會以極高速度產出大量結構漂亮的醫學廢話。
AI 放大的是我們的專業思考能力,而不是替我們思考。 臨床經驗、病理生理直覺、對病患幽微症狀的洞察,才是灌注給 Agent 靈魂的核心燃料。
第三,從今天開始,打造你的「外部數位大腦」
別再依賴每次重新打開 ChatGPT 的空對話框。開始嘗試把自己的教學思維、習慣的簡報架構、嚴選的經典文獻指引,轉化為結構化的筆記與提示範本。當開始累積屬於自己的工作流資產,我們就不再只是被科技浪潮推著走的追隨者,而是在數位時代擁有個人專屬智庫的高效臨床工作者。
❓ 七、寫在最後:你現在停在哪一個階段?
回頭看看桌面與瀏覽器分頁:
- 我們現在使用 AI,是把它當成一個偶爾問問翻譯、查查資料的「進階版 Google 搜尋框」?
- 還是已經開始嘗試用它處理數據、簡化重複操作的「小工具」?
- 抑或是,已經開始思考,如何將自己多年累積的專科獨門知識,打造成具備嚴格治理、能自主協同運作的「專屬醫療 Agent 隊列」?
這不是一場工程師的技術競賽,這是一場每一位臨床醫師如何奪回時間自主權、放大專業影響力的工作方式革命。
未來的頂尖醫師,或許不一定是最會背指引的人,但一定是最懂得如何指揮 AI 團隊、同時守住醫療安全與倫理底線的卓越指揮官。
【臨床同儕交流與思考】
📚 參考文獻與實證出處(References)
- Topol, E. J. (2019). *High-performance medicine: the convergence of human and artificial intelligence.* Nature Medicine, 25(1), 44-56.
- Rajpurkar, P., Chen, E., Banerjee, O., & Topol, E. J. (2022). *AI in health and medicine.* Nature Medicine, 28(1), 31-38.
- Global Initiative for Asthma (GINA). (2025/2026 update). *Global Strategy for Asthma Management and Prevention: Difficult-to-treat & Severe Asthma Guide.*
- Moor, M., Banerjee, O., Abad, Z. S. H., et al. (2023). *Foundation models for generalist medical artificial intelligence.* Nature, 616(7956), 259-265.
- aidrchou.com 臨床 AI 實踐研究專題. (2026). *基於開源技術之醫療 Agentic Workflow 實踐藍圖.*