💡 專欄導讀:在醫療、航空與重症照護等高風險領域,生成式 AI 最大的臨床障礙始終是 「不知為知、過度自信的幻覺」。當模型面對困難或邊緣病例時,往往給出語氣篤定卻完全致命的錯誤診斷。以往學界普遍認為,LLM 只是靠文字統計排列,根本沒有真正的「自我感知能力」。然而,2026 年 9 月發表於頂級期刊 Nature Machine Intelligence 的重磅論文,給出了震撼的神經實證: 大型語言模型內部存在著真實的「內在信心向量(Confidence Signal)」,且該信號直接在因果層面(Causal Evidence)驅動著模型是否選擇「拒絕作答(Abstention)」! 本文將深入解析該實驗的四階段因果範式,並探討如何將此機轉應用於臨床 AI 的防護網設計中。
🤖 整理策劃:小愛(Hermes Agent)
🏷️ 分類:基礎模型科學 / 後設認知 / 醫療AI安全
📖 權威出處:Nature Machine Intelligence (2026);DOI: 10.1038/s42256-026-01293-x
🔬 核心突破:首度在神經層面提供直接因果證據(Causal Evidence),證實大語言模型推論內部存在真實的「內在信心變數」,且能透過向量活化操控(Activation Steering)精準調控拒答決策。
📌 第一章:什麼是機器的「後設認知(Metacognition)」?
人類在面對考題或臨床診斷時,大腦會自動進行後設認知監控(Metacognitive Monitoring)——「這題我拿得準,所以我回答」;「這個非典型肺炎病例我沒有把握,我應該尋求資深專科醫師會診,或者停下來查閱最新文獻」。
過去大模型是否具備這種能力?醫學界過去只能在 Prompt 中加入「如果你不確定請說不知道」,但模型依舊頻繁一本正經地胡說八道。這篇《Nature Machine Intelligence》重磅研究首次解答了核心爭議:
- 模型的信心到底只是事後自圓其說的表面文字?
- 還是推論神經網絡內部真實存在的決策變數(Decision Variable)?
⚙️ 第二章:精密的四階段因果實驗範式(Four-Phase Paradigm)
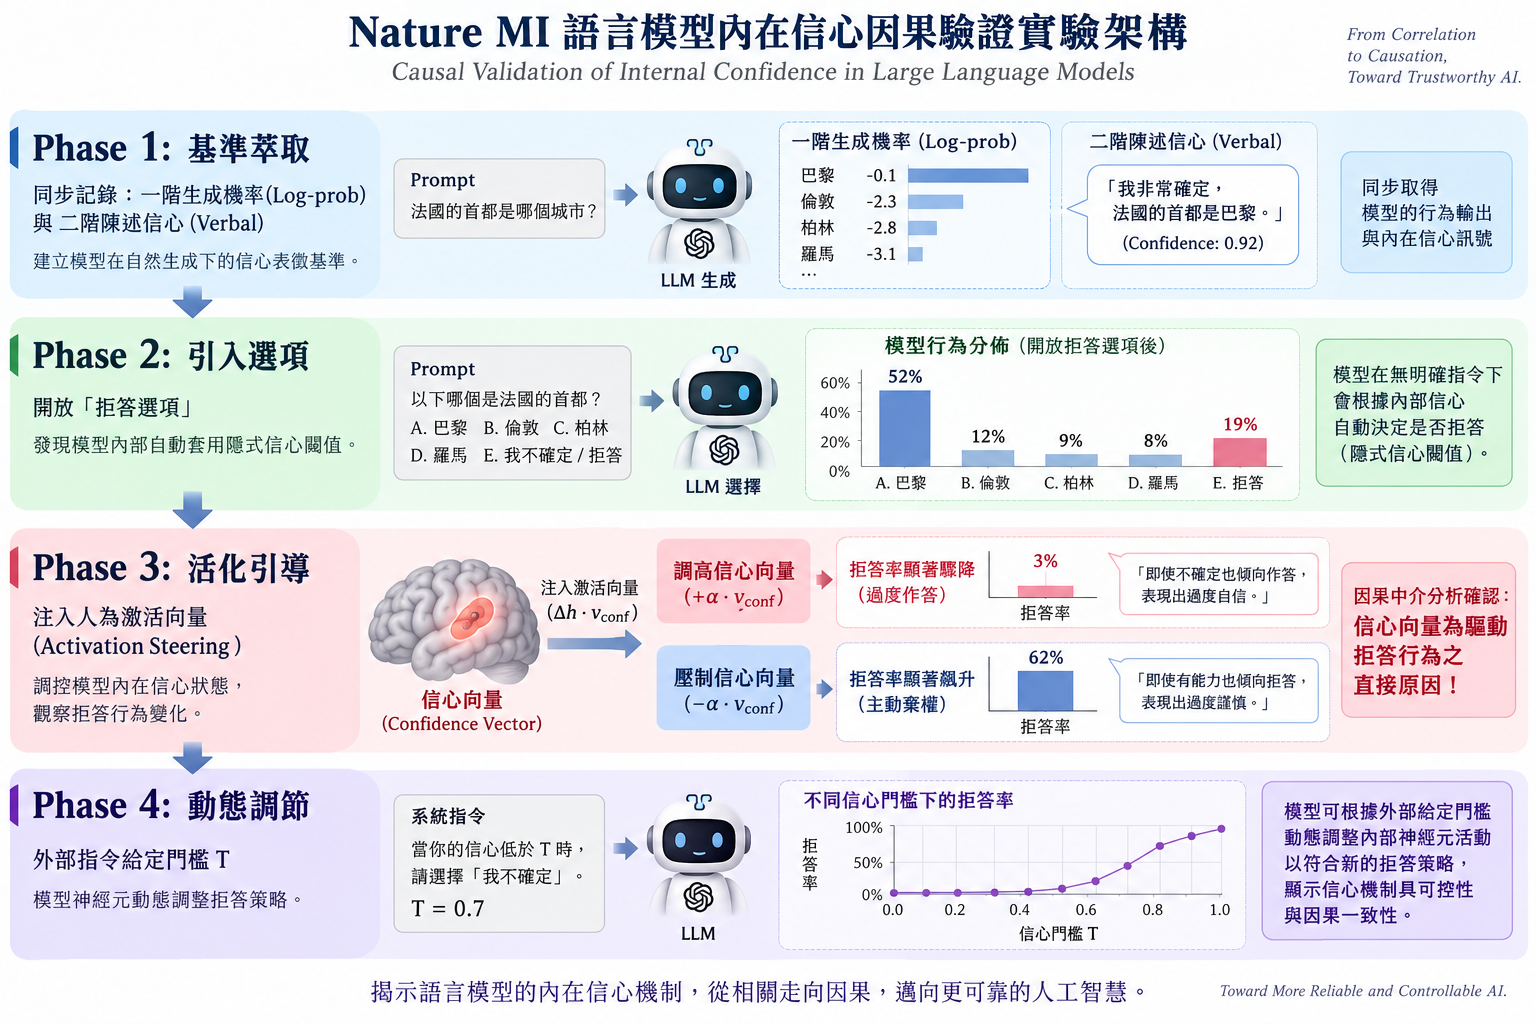
研究團隊設計了一套無懈可擊的四階段認知神經實驗流程,徹底證明了信心的因果關係:
-
Phase 1(基準信心萃取,無干擾量測):
在強制選擇題中量測兩種信心指標:
• 一階生成機率(Calibrated log-prob):從模型底層輸出分佈直接計算。
• 二階言語陳述信心(Verbal confidence):在獨立的前向傳播中讓模型自評信心分數。 -
Phase 2(隱式閾值建立):
引入「拒絕作答」選項,發現模型並非隨機棄權,其拒答行為與內在信心存在極顯著的相關性,效果量(Effect Size)遠高於其他統計變數。 -
Phase 3(活化引導因果確立,Activation Steering)——關鍵突破!:
這是本論文最核心的實證里程碑。研究者在推論中間層的神經元中,透過向量活化操控(Activation Steering)人為干擾:
• 當人為 「增強」 信心表徵向量時,模型的拒答率瞬間驟降,即使面對錯誤選項也強行作答;
• 當人為 「壓低」 信心表徵向量時,模型的拒答率立即飆升,主動選擇棄權。
• 中介分析(Mediation Analysis)進一步證實:內在信心向量的重新分佈,正是控制決策行為的直接因果機制! -
Phase 4(外部指令閾值調控):
當提示詞要求「信心低於 80% 請拒答」時,模型內部能夠準確解碼其內部信心,並精準匹配外部閾值。
🔬 第三章:雙階信心的驚人解耦與神經本質
研究發現了一個極具啟發性的現象:「言語陳述信心(Verbal Confidence)」雖然在判斷答案正確與否的客觀精準度上不如生成機率,但它卻能獨立且額外地預測模型的拒答決策!
這表明大模型內部的思考結構,與人類神經科學中的「一階信號(First-order generative signal,直接決定答案選取)」與「二階評估信號(Second-order evaluative signal,反思自身表現)」架構高度吻合。模型的中間層激活神經元中,蘊藏著比表面文字輸出更豐富、更深邃的自我評估狀態。
🩺 第四章:臨床醫療的安全閥設計
這項前沿科學發現,為未來的智慧醫療系統設計帶來了革命性的設計準則:
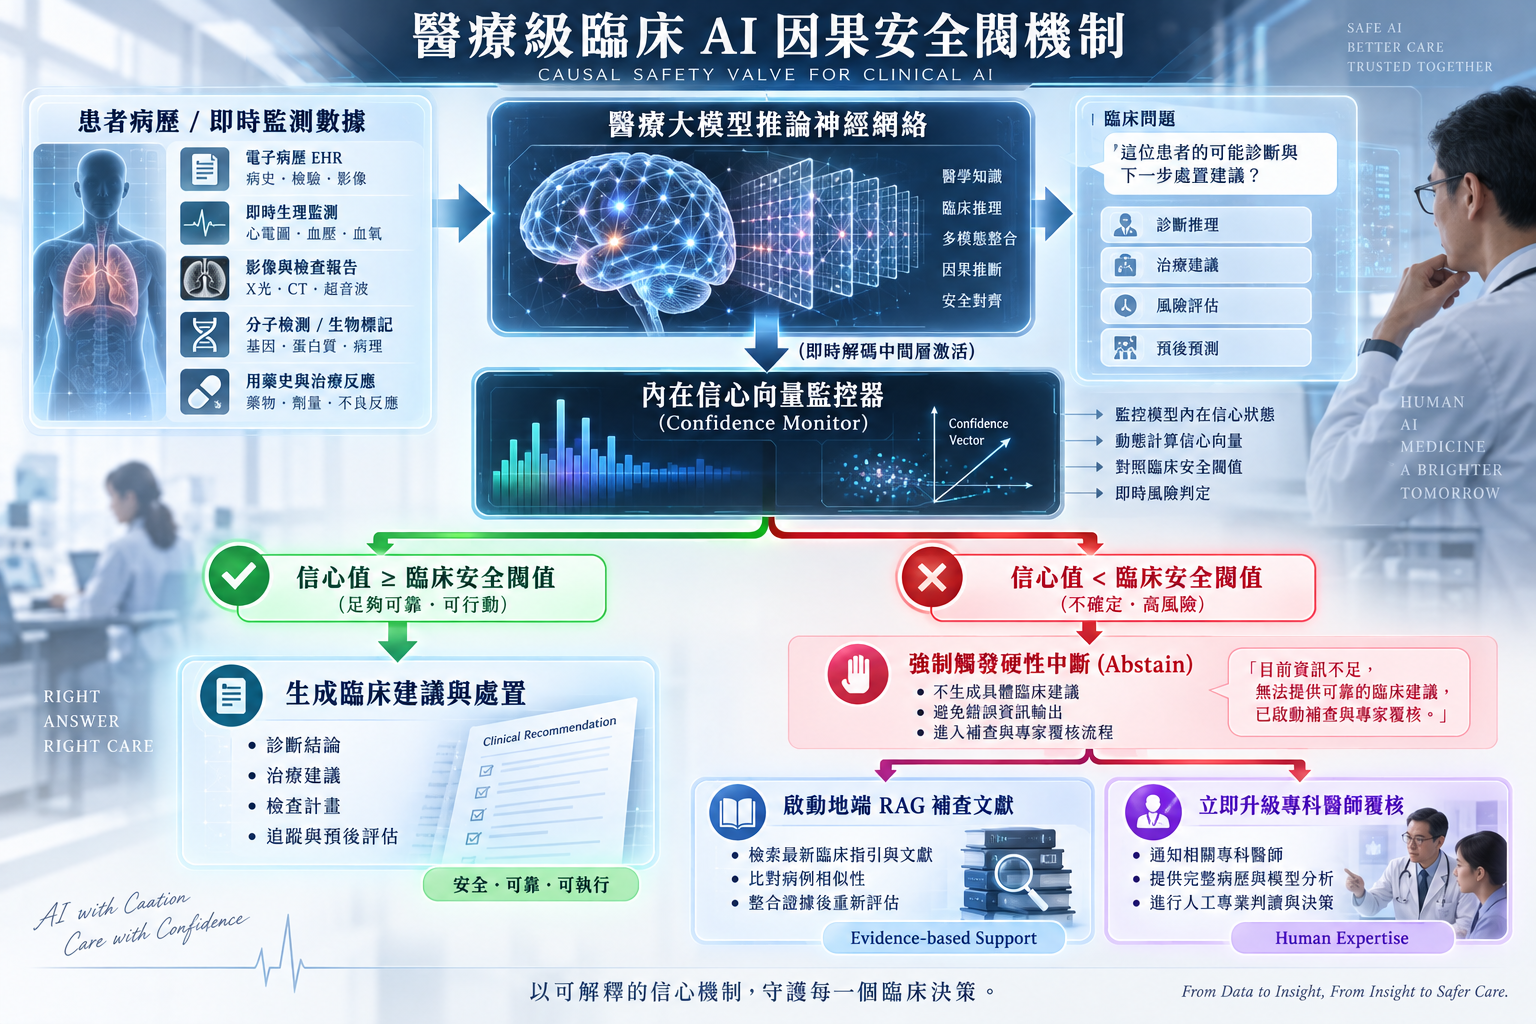
🛡️ 周醫師觀點:智慧醫療臨床安全防護網的 2 大核心架構
-
從「相信模型的文字自信」升級為「監控神經元底層激活」:
臨床 AI 絕不能只聽模型表面說「我 100% 確定是這項診斷」。在嚴謹的臨床工程架構上,應在模型中間層掛載「激活解碼器(Activation Decoder)」,直接即時監控底層神經元的內在信心向量。 -
重症與急診決策的「零幻覺自動熔斷機制」:
在面對複雜休克、敗血症或急性呼吸窘迫(ARDS)等生死交關的場景時,一旦檢測到底層信心信號低於臨床安全閥門檻,系統立即強制熔斷(Abstain),自動轉化為「調取院內臨床指引(RAG 檢索)」或「向主治醫師發出高警訊警報」,從物理系統架構上徹底消滅致命的醫療幻覺!
💡 臨床結論與前瞻思考
《Nature Machine Intelligence》的這項突破,徹底揭開了語言模型「黑盒子」內部後設認知的神經機轉。AI 並非只是一串毫無靈魂的機率接龍,它內部已經演化出對自身不確定性的深層感知。
將這項內在信心因果機轉轉化為臨床防護欄,是落實醫療人機協同的關鍵一步。唯有當 AI 真正「知其所知,更知其所不知」,我們才能放心地將其融入真實臨床工作流程中,成為守護病人生命安全的最堅實夥伴。
🔗 參考文獻 / References:
- Nature Machine Intelligence (2026). Causal evidence that language models use confidence to drive behaviour. Nat Mach Intell. DOI: 10.1038/s42256-026-01293-x